多 Agent 的本质不是分工,而是注意力治理
很多 AI 产品把 Agent 设计成角色,但真正决定系统能力的,是上下文、工具、状态和环境隔离。很多多 Agent 产品,都在试图把 AI 做成一个小公司。打开产品介绍页,你很容易看到类似配置:Research Agent 找资料,Writer Agent 写内容,Review...
📋 文章摘要
本文针对当前多 Agent 产品中普遍存在的「角色化设计」倾向提出了批判性反思,核心观点为:多 Agent 的本质不是分工,而是注意力治理。
核心论点
- 角色化误区:多数产品将 Agent 设计为角色(Research Agent、Writer Agent、Review Agent),但角色名 ≠ 系统能力,角色本身不产生能力,边界才产生能力。
- 注意力治理视角:Agent 不是一种角色身份,而是一种「注意力状态」——系统在特定时刻应关注什么信息、调用什么工具、修改什么状态。
- 六大边界:真正区分 Agent 的是六种边界——上下文、工具、状态、环境、反馈、记忆。公式:
Agent = Attention Scope + Context Scope + Tool Scope + State Scope + Environment Scope + Feedback Scope。 - 何时拆 Agent:只有当需要不同上下文、不同工具权限、独立环境、独立验证或目标冲突时,才值得拆分。
- 操作系统隐喻:好的多 Agent 系统更像操作系统(资源调度、权限分配、进程隔离、异常恢复),而非公司组织图。
文章结构
- 为什么把 Agent 分成角色 — 人类认知习惯 + 产品化需要 + prompt 时代惯性
- 角色化的误区 — 把名字当成边界,Review Agent 案例揭示虚假安全性
- Agent = 注意力状态 — 研究/写作/审查/执行本质上是不同的注意力模式
- 真正要设计的是边界 — 上下文、工具、状态、环境、反馈、记忆六大边界
- 什么时候拆 Agent — 边界不同才值得拆,否则只是多 prompt
- 操作系统隐喻 — 从公司组织图转向注意力操作系统的治理范式
- 重新理解多 Agent — 角色留在界面,系统治理的是边界
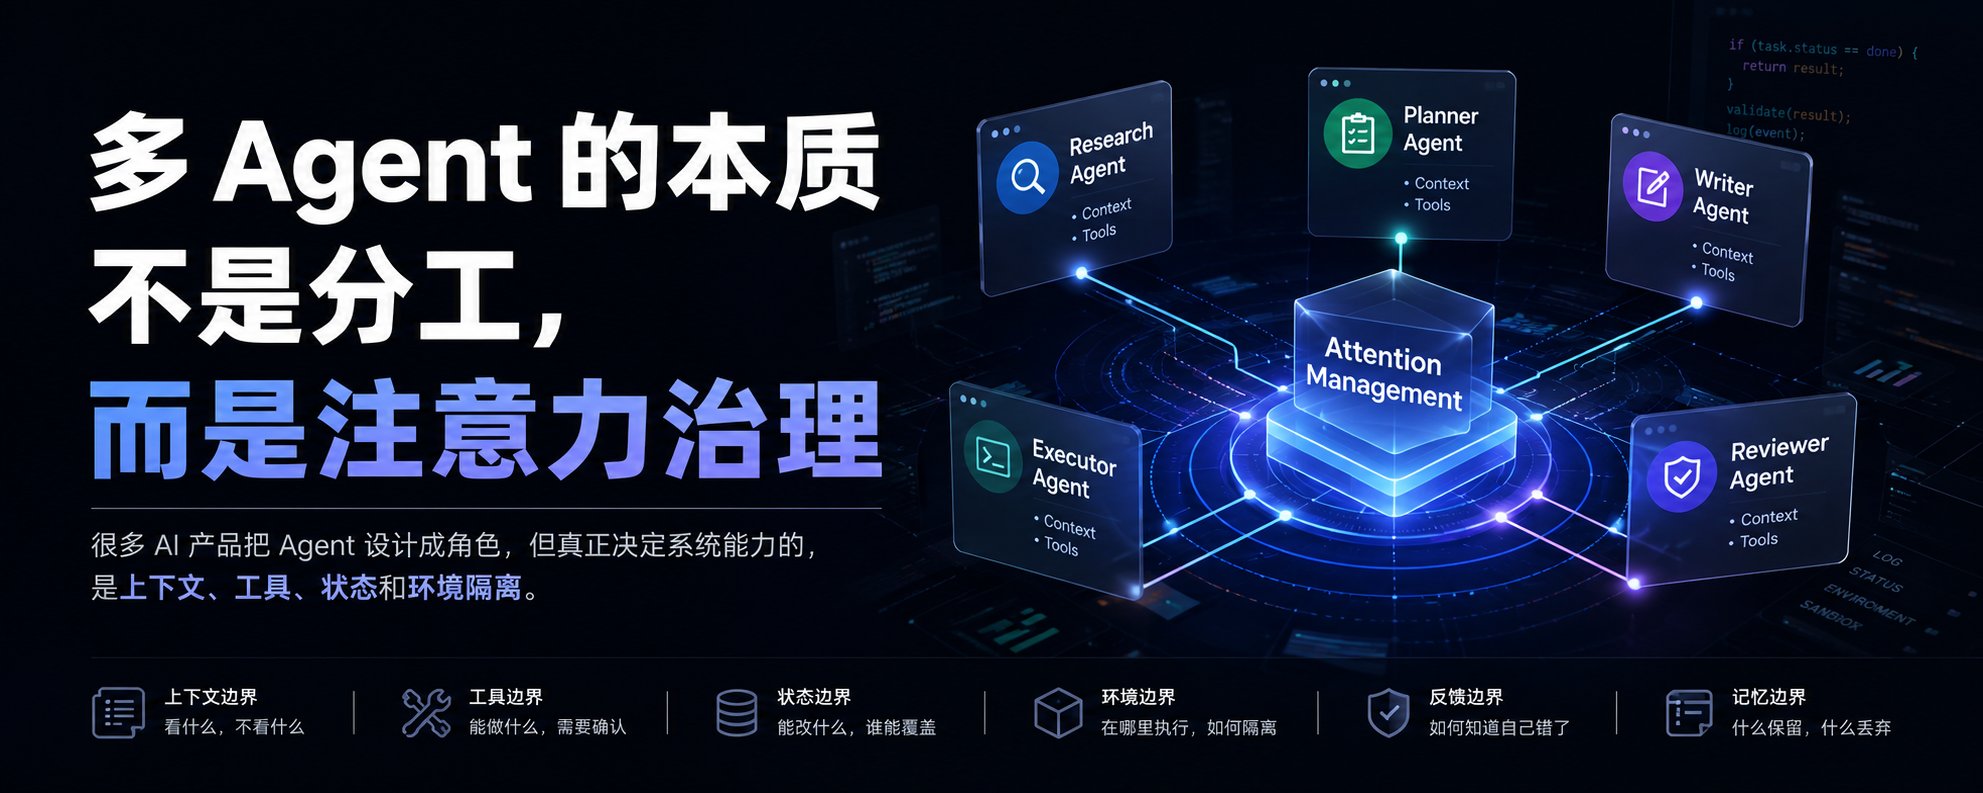
很多 AI 产品把 Agent 设计成角色,但真正决定系统能力的,是上下文、工具、状态和环境隔离。
很多多 Agent 产品,都在试图把 AI 做成一个小公司。
打开产品介绍页,你很容易看到类似配置:Research Agent 找资料,Writer Agent 写内容,Reviewer Agent 挑错,Planner Agent 拆任务,Executor Agent 调工具。
看起来,一个复杂任务被拆成了几个岗位,几个 AI 角色像团队一样协作。
这个隐喻很顺,也很好卖。
但也正因为太顺,它可能从一开始就把问题带偏了。
它默认复杂 AI 系统应该像人类组织一样运转:复杂任务需要拆解,拆解之后需要分工,分工之后需要角色。
问题是,LLM 不是员工,Agent 也不是岗位。
一个 Agent 是否真的有用,不取决于它叫什么,而取决于它在某一刻能看见什么、能调用什么工具、能修改什么状态、是否运行在独立环境里,以及错误发生之后能不能被发现、隔离和回滚。
如果这些东西没有变化,只是把同一个模型叫成研究员、写手、审查员,那所谓多 Agent 就不是系统架构,而是多角色剧本。
所以我真正想问的不是“多 Agent 有没有用”,而是三个更底层的问题:
为什么我们一做多 Agent,就会自然地把它设计成角色?
这种角色化设计到底误导了什么?
如果角色不是 Agent 系统的真实边界,那真正应该被设计的边界是什么?
我的判断是:
多 Agent 的本质不是分工,而是注意力治理。
一、为什么我们总是先把 Agent 分成角色?
把 Agent 分成角色,并不奇怪。
甚至可以说,这是最自然的产品表达方式。
第一,人类理解复杂协作时,最熟悉的方式就是组织分工。公司是这样运转的,项目组是这样运转的,内容团队也是这样运转的。一个人负责研究,一个人负责写作,一个人负责审查,一个人负责执行。这个模型太熟悉了。
第二,角色更容易被产品化。
“一个 AI 团队帮你完成任务”,显然比“一个上下文路由系统根据任务状态动态调度工具、记忆和执行环境”更好理解,也更好传播。
第三,角色继承了 prompt 时代的习惯。
过去我们习惯这样写提示词:
你是一名资深产品经理。 你是一名经验丰富的律师。 你是一名顶级架构师。
到了 Agent 时代,这种写法自然变成了:
你是 Research Agent。 你是 Coding Agent。 你是 Review Agent。
所以,角色化不是愚蠢。
它是自然的,也是有用的。
角色适合给用户看,因为它降低理解成本,让复杂系统变得可指挥、可观察、可描述。
但产品翻译不能替代系统架构。
用户看到研究员、写手、审查员没有问题。问题是,如果系统内部也只是几个 role prompt 在互相传话,那就不是多 Agent 架构,而是多角色剧本。
角色可以解释任务,但角色本身不产生能力。
二、角色化的误区:把名字当成边界
角色化多 Agent 最大的问题,是把“角色名”误当成了“系统边界”。
一个 Agent 叫 Research Agent,不代表它真的具备研究能力。
它是否真的能研究,要看它能不能访问资料源,能不能区分证据质量,能不能保留引用,能不能标注不确定性,能不能在证据不足时停止生成。
一个 Agent 叫 Review Agent,也不代表它真的能审查。
Review Agent 最能暴露这个问题。
一个写作 Agent 生成文章,另一个 Review Agent 负责审查。听起来很合理:一个生产,一个把关。
但如果 Review Agent 只能看到成稿,看不到原始资料、搜索记录、用户要求、事实来源和修改历史,也没有权力阻止发布,那它所谓的审查就只是文本评论。
它可以判断这篇文章结构是否清楚,语气是否自然,有没有明显矛盾。
但它很难判断事实是否可靠,也很难发现前一个 Agent 编造了来源。
这时候,Review Agent 这个名字制造的是安全感,不是安全性。
一个真正有效的 Review Agent,不应该只是“会挑错的角色”。它至少应该拿到证据链、变更记录、测试结果和发布阻断权。否则它只是在做文本评论,不是在做审查。
审查不是一个名字,而是一组边界。
真正的分工不是把名字拆开,而是把边界拆开。
人类团队里的分工之所以有效,不只是因为有不同岗位,还因为不同岗位背后有不同经验、权限、责任、信息渠道、评价标准和风险承担。
但很多多 Agent 系统里,所谓不同角色可能看到的是同一批上下文,调用的是同一批工具,修改的是同一个状态,错误也没有被隔离。
如果这些边界没有变化,所谓不同 Agent 只是不同人设。角色越多,信息传递链条越长,中间产物越多,错误被包装和放大的机会也越多。
所以,判断一个 Agent 是否真的独立,不应该看它叫什么,而应该看它有没有独立边界:
它是否看到不同的上下文?
它是否拥有不同的工具权限?
它是否运行在不同环境里?
它是否有不同的目标函数?
它是否有独立的反馈和纠错机制?
如果答案都是否,那么这个 Agent 只是一个角色 prompt。
角色不是能力,边界才是能力。
三、Agent 不是身份,而是注意力状态
这里说的 attention,不是狭义的 Transformer 注意力机制,而是 Agent 系统里的调度问题:
每一步行动之前,系统如何决定什么信息重要,什么信息该忽略,什么工具该打开,什么状态不能被污染。
所以,我更愿意把 Agent 理解成一种注意力状态,而不是一种角色身份。
研究不是一个角色,而是一种注意力状态:系统此刻优先关注证据、来源、质量和不确定性。
写作不是一个角色,而是一种注意力状态:系统此刻优先关注结构、表达、节奏和读者路径。
审查不是一个角色,而是一种注意力状态:系统此刻优先关注漏洞、反证、风险和过度断言。
执行不是一个角色,而是一种注意力状态:系统此刻优先关注工具调用、环境变化、执行结果和错误反馈。
从这个角度看,多 Agent 不是把 AI 分成人,而是把复杂任务拆成几种不同的注意力模式。
这和角色分工看起来很像,但底层逻辑完全不同。
角色分工问的是:
谁负责什么?
注意力治理问的是:
当前系统最应该关注什么?
更具体地说,是这些问题:
哪些信息应该进入上下文?
哪些信息应该被忽略?
哪些工具应该开放?
哪些状态可以修改?
哪些动作必须隔离?
哪些结果会反馈到下一步?
四、真正要设计的是边界
如果 Agent 不是靠名字区分,那就只能靠边界区分。
我认为至少有六种边界。
上下文边界:它此刻能看什么,不能看什么。上下文太脏,模型再强也会被带偏。
工具边界:它能调用什么,哪些动作需要确认。工具不是能力列表,而是行动边界。
状态边界:它能修改什么,谁能覆盖主状态。没有状态边界,多 Agent 就是在多人同时改同一份文件。
环境边界:它在哪里执行,错误会不会污染真实环境。代码、数据库、浏览器和 API 都不是纯文本空间。
反馈边界:它如何知道自己错了。评论不是验证,测试、日志、事实校验才是反馈。
记忆边界:什么进入下一轮,什么应该丢弃。没有记忆无法积累,记忆失控会污染系统。
这些边界合在一起,才构成一个真正的 Agent。
更准确地说:
Agent = Attention Scope + Context Scope + Tool Scope + State Scope + Environment Scope + Feedback Scope
一个 Agent 的本质,不是它叫什么,而是它被允许关注什么、读取什么、调用什么、修改什么、在哪里执行,以及如何根据反馈调整下一步行动。
尤其是当 Agent 从聊天走向行动,这些边界会变得越来越重要。
聊天模型说错话,问题主要停留在文本层。
但 Agent 一旦能行动,它就可能改代码、删文件、调 API、写数据库、发邮件、提交表单、操作浏览器。
这个时候,真正重要的不是它的角色名,而是它有没有沙箱、日志、权限控制、回滚机制和人工确认。
行动意味着权限。
权限意味着风险。
风险意味着隔离。
隔离意味着系统设计。
五、什么时候真的应该拆 Agent?
是否拆 Agent,不应该看角色是否听起来合理,而应该看边界是否真的不同。
需要不同上下文,值得拆。
需要不同工具权限,值得拆。
会修改独立环境,应该拆。
需要独立验证,应该拆。
目标函数天然冲突,也应该拆。
反过来,如果几个 Agent 看到的是同样的上下文,用的是同样的工具,修改的是同样的状态,只是说话风格不同,那就没有必要拆。
那不是多 Agent。
那只是多 prompt。
六、好的多 Agent 系统更像操作系统,而不是公司组织图
如果说角色化多 Agent 借用的是公司隐喻,那么我觉得更好的隐喻其实是操作系统。
公司组织图关心的是责任分配:
谁负责什么?
操作系统关心的是资源治理:
资源如何调度,权限如何分配,进程如何隔离,异常如何恢复。
真正可靠的 Agent 系统,更接近后者。
它管理的不是一群“AI 员工”,而是一组运行中的认知进程。
谁能读取哪些上下文?
谁能调用哪些工具?
谁能修改哪些状态?
谁的错误会不会污染主环境?
谁的结果必须经过验证才能进入下一步?
从这个角度看,一个好的多 Agent 系统,需要的不是更多角色,而是更好的运行时治理。
它需要调度注意力,而不是堆角色。
它需要管理上下文,而不是塞满上下文。
它需要控制权限,而不是开放所有工具。
它需要隔离环境,而不是直接污染主系统。
它需要记录日志,而不是只留下最终答案。
它需要处理反馈,而不是让模型互相评论。
这些问题,靠角色名解决不了。
角色可以让用户更容易理解系统,但真正让系统可靠的是调度、权限、隔离、状态和反馈。
所以,好的多 Agent 系统不应该只像一张公司组织图。
它更应该像一个注意力操作系统。
用户看到的可以是角色。
系统实现的必须是边界。
七、重新理解多 Agent
所以,多 Agent 真正的问题不是:
我们需要几个角色?
而是:
这个任务需要几种不同的注意力状态?
进一步说,是这些问题:
每种状态应该看什么?
能调用什么?
能修改什么?
在哪里执行?
如何验证?
如何回滚?
如果这些问题没有被回答,多 Agent 只是角色表演。
如果这些问题被认真设计,多 Agent 才可能从产品隐喻变成系统架构。
角色可以留在界面上。
但系统真正要治理的,是注意力、上下文、工具、状态、环境和反馈。
多 Agent 的本质不是分工,而是注意力治理。