nvml-mock
nvml-mock
📝 摘要
nvml-mock 是 NVIDIA 官方的 Kubernetes Helm Chart,通过 CGo 编译的 mock libnvidia-ml.so 共享库,在无物理 GPU 的集群中模拟完整的多 GPU 环境,使 nvidia-smi、device plugin、DRA driver 等 GPU 相关 K8s 组件无需真实硬件即可运行和测试。它部署为 DaemonSet + ConfigMap + RBAC,在每个节点上创建 mock NVML 库、设备节点、InfiniBand sysfs 树和 PCI sysfs 树,消费者通过 --nvidia-driver-root=/var/lib/nvml-mock/driver 接入。内置 7 个 GPU profile(A100/GB300 覆盖 Ampere→Blackwell Ultra),支持 InfiniBand 三层 LD_PRELOAD 模拟(sysfs+UMAD+verbs)、PCIe 拓扑模拟、NRI 插件透明注入、动态指标和故障注入(lost/fallen_off_bus/ecc_uncorrectable)。主要限制是 Go 程序的 PCIe sysfs 拦截问题导致 DRA 拓扑感知调度不可用。
核心概念: 用 CGo mock NVML 共享库替代真实 GPU 驱动,使任何通过标准 NVML API 查询的程序都能在无 GPU 环境中正常工作,实现 GPU 依赖组件的零硬件测试。
关键技术栈 / 关键要点:
- CGo mock NVML 库 — 编译为
libnvidia-ml.so,实现完整 NVML API,nvidia-smi可直接运行 - 7 个内置 GPU Profile — A100→GB300 覆盖 Ampere/Hopper/Blackwell/Blackwell Ultra,含真实规格(显存/NVLink/TDP/驱动版本)
- InfiniBand 三层 LD_PRELOAD —
libibmocksys.so+libibmockumad.so+libibmockverbs.so协同模拟 IB,ibstat/ibping/iblinkinfo可用 - NRI 插件透明注入 — 容器创建时注入 mock 环境,普通 pod 无需修改 pod-spec 即可运行
nvidia-smi - 故障注入 — 4 种模式(healthy/lost/fallen_off_bus/ecc_uncorrectable),支持确定性和随机性触发
- 与 fake-gpu-operator 互补 — 驱动级保真(NVML API)vs K8s API 级规模模拟(虚拟节点)
关键结论 / 实践建议: 使用 a100 profile 兼容性最广;安装 NRI 插件时必须指定独立 namespace(-n nvml-mock --create-namespace);Go 程序的 LD_PRELOAD 限制是当前最大已知问题,DRA 拓扑感知调度暂时不可用。
一句话定义:nvml-mock 是 NVIDIA 官方的 Kubernetes Helm Chart,通过 CGo 实现的 mock NVML 共享库,在无物理 GPU 的集群中模拟完整的多 GPU 环境,用于测试 GPU 相关的 K8s 组件。
Open: Pasted image 20260804132544.png
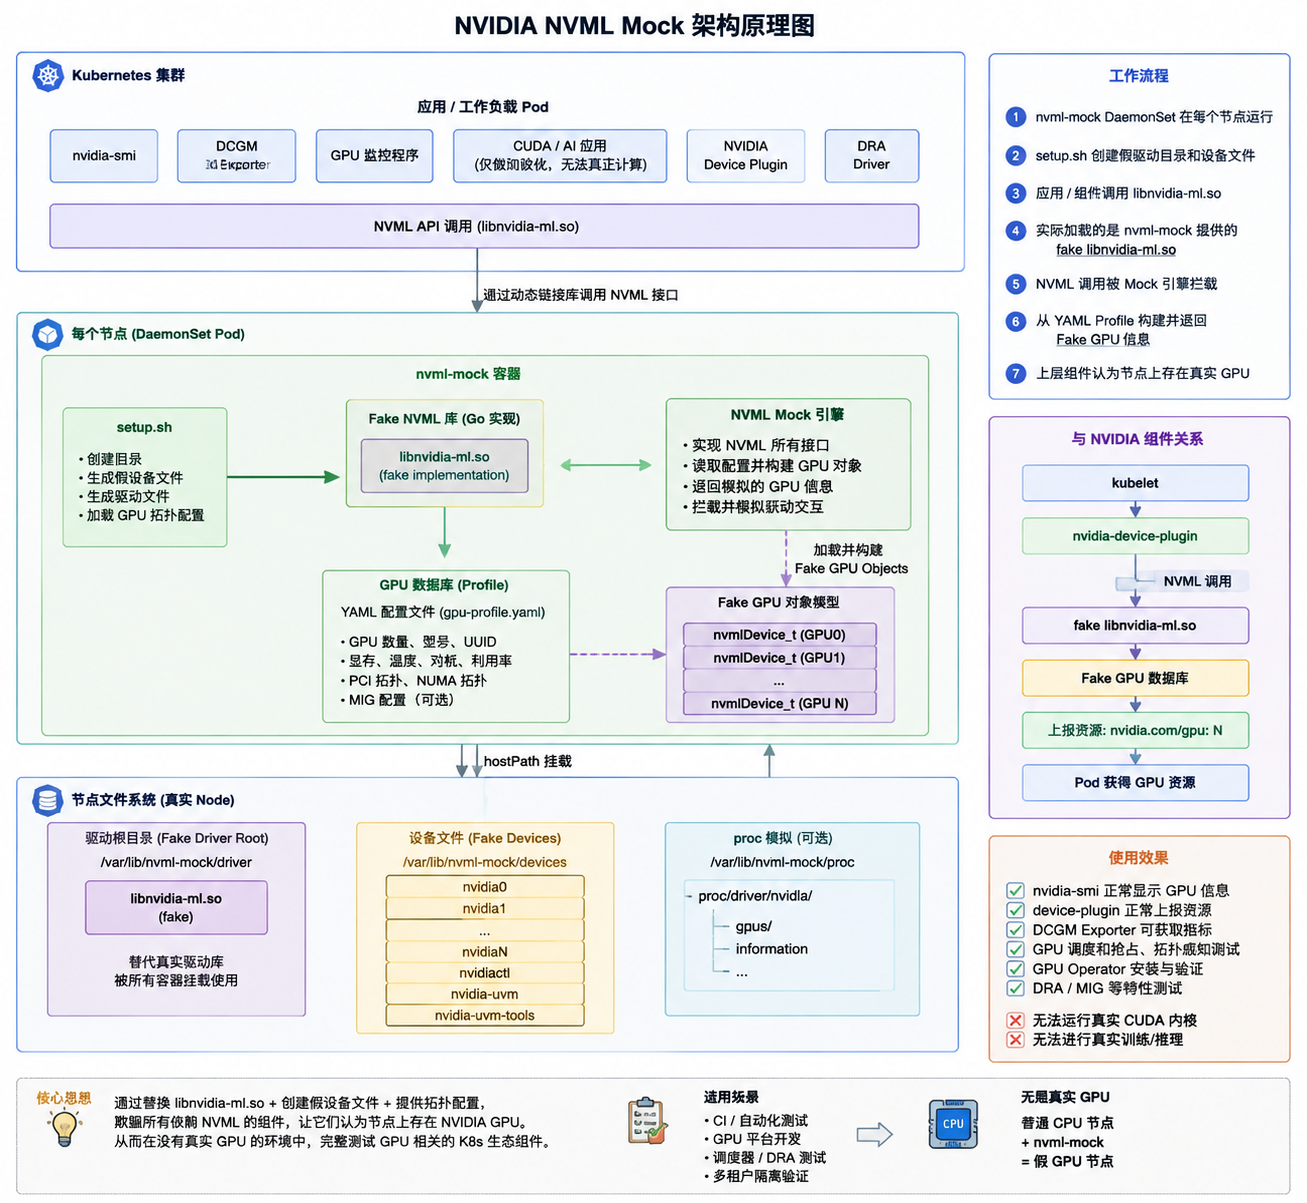
概览
| 项目 | 详情 |
|---|---|
| 仓库 | NVIDIA/k8s-test-infra /deployments/nvml-mock/ |
| 镜像 | ghcr.io/nvidia/nvml-mock:latest |
| Helm Chart | oci://ghcr.io/nvidia/k8s-test-infra/chart/nvml-mock |
| 底层库 | NVIDIA/go-nvml /pkg/nvml/mock — Go mock 实现 |
| 许可 | Apache 2.0 |
核心架构
设计思路
nvml-mock 的核心是 CGo 编译的 libnvidia-ml.so 共享库,它实现了完整的 NVML API,但返回的是配置文件中定义的静态/动态数据。任何通过标准 NVML API 查询 GPU 的程序(nvidia-smi、device plugin、DRA driver)都能正常工作,无需知道底层是模拟的。
部署组件
Chart 部署三个核心资源:
┌─────────────────────────────────────────────────────┐
│                    Helm Release                      │
├─────────────┬───────────────┬───────────────────────┤
│  DaemonSet  │   ConfigMap   │        RBAC           │
│  (每个节点)  │  (GPU 配置)    │  (Node label 权限)    │
└──────┬──────┴───────┬───────┴───────────────────────┘
       │              │
       ▼              ▼
 ┌─────────────────────────────────────────────────┐
 │          /var/lib/nvml-mock/                     │
 │  ├── driver/usr/lib64/libnvidia-ml.so.*         │
 │  ├── driver/dev/nvidia{N,ctl,-uvm,-uvm-tools}   │
 │  ├── driver/config/config.yaml                  │
 │  ├── ib/sys/class/infiniband/...                │
 │  └── sys/bus/pci/devices/...                    │
 └─────────────────────────────────────────────────┘
-
DaemonSet — 特权容器(
privileged: true,需要mknod),在每个节点上:- 复制
libnvidia-ml.so.{version}到/var/lib/nvml-mock/driver/usr/lib64/ - 创建符号链接处理库版本化
- 创建 mock 设备节点
/dev/nvidia{N,ctl,-uvm,-uvm-tools} - 写入 GPU 配置 YAML
- 给节点打标签
nvidia.com/gpu.present=true - 写入 NFD feature file 生成
feature.node.kubernetes.io/pci-10de.present=true - 创建 fake InfiniBand sysfs 树
- 创建 fake PCI sysfs 树
- 复制
-
ConfigMap — 从选定的 GPU profile 生成的 GPU 配置
-
RBAC — ServiceAccount,拥有节点标签修补权限
消费者接入
消费者组件挂载 /var/lib/nvml-mock 并使用 --nvidia-driver-root=/var/lib/nvml-mock/driver,通过标准 NVML API 路径发现 GPU:
# Device Plugin 示例
kubectl apply -f tests/e2e/device-plugin-mock.yaml

# DRA Driver 示例
helm install nvidia-dra-driver-gpu nvidia/nvidia-dra-driver-gpu \
  --set nvidiaDriverRoot=/var/lib/nvml-mock/driver
Dockerfile 构建产物
构建阶段(golang:1.26.5-bookworm)
Mock 共享库(CGo 编译):
| 源码路径 | 产物 | 用途 |
|---|---|---|
pkg/gpu/mocknvml |
libnvidia-ml.so.* |
模拟 NVML API |
pkg/gpu/mockcuda |
libcuda.so.* |
模拟 CUDA API |
pkg/network/mockib |
libibmocksys.so.*, libibmockumad.so.*, libibmockverbs.so.* |
模拟 InfiniBand |
pkg/system/mockpcisysfs |
libpcimocksys.so.* |
模拟 PCI sysfs |
Go 二进制:
| 二进制 | 用途 |
|---|---|
mock-ib |
InfiniBand mock daemon(SA 查询、ibping) |
nvml-mock-nri |
NRI 插件(容器创建时注入 mock 环境) |
nvml-mock-ctl |
控制工具 |
render-pci-sysfs |
渲染 PCI sysfs 树 |
render-imex-procdevices |
渲染 IMEX proc 设备 |
nvidia-imex / nvidia-imex-ctl |
fake IMEX daemon/ctl |
nv-fabricmanager / nv-fabricmanager-ctl |
fake Fabric Manager daemon/ctl |
check-fabric |
Fabric 健康检查 |
运行阶段(debian:bookworm-slim)
- 安装 InfiniBand 工具(
infiniband-diags,rdma-core,ibverbs-utils) - 提取
nvidia-smi(从 NVIDIA 580 分支,支持 GB200 NVLink5) - 下载
kubectlv1.36.1 - 用
patchelf设置 RPATH($ORIGIN/../lib64)使工具在重定位挂载上下文中找到库
GPU Profiles
七个内置 profile 提供真实的数据中心 GPU 规格:
| Profile | 全名 | 架构 | 显存 | NVLink | TDP | 驱动版本 |
|---|---|---|---|---|---|---|
a100 (默认) |
A100-SXM4-40GB | Ampere (8.0) | 40 GiB HBM2e | v3, 600 GB/s | 400W | 550.163.01 |
h100 |
H100 80GB HBM3 | Hopper (9.0) | 80 GiB HBM3 | v4, 900 GB/s | 700W | 550.163.01 |
b200 |
B200 | Blackwell (10.0) | 192 GiB HBM3e | v5, 1.8 TB/s | 1000W | 560.35.03 |
gb200 |
GB200 NVL | Blackwell (10.0) | 192 GiB HBM3e | v5, 1.8 TB/s | 1000W | 560.35.03 |
gb300 |
GB300 NVL | Blackwell Ultra (10.0) | 288 GiB HBM3e | v5, 1.8 TB/s | 1400W | 570.124.06 |
l40s |
L40S | Ada Lovelace (8.9) | 48 GiB GDDR6 | — | 350W | 550.163.01 |
t4 |
Tesla T4 | Turing (7.5) | 16 GiB GDDR6 | — | 70W | 550.163.01 |
选择建议:
a100— 兼容性最广,多数 NVIDIA 软件假定 A100h100— Hopper 特性:FP8、Transformer Engine、PCIe Gen5b200— Blackwell 特性:FP4、NVLink v5、PCIe Gen6gb200/gb300— Grace-Blackwell Superchip:NVLink-C2C、统一内存l40s— Ada Lovelace 推理:FP8、PCIe Gen4t4— 低功耗推理(70W)
InfiniBand 模拟
三层 LD_PRELOAD 架构
三个 shim 协同工作(预加载顺序 libibmockumad.so:libibmockverbs.so:libibmocksys.so):
┌──────────────────────────────────────────────────────────┐
│                    用户态进程                              │
│  (ibstat, ibstatus, iblinkinfo, ibv_devinfo -l)          │
├──────────────────────────────────────────────────────────┤
│  libibmocksys.so   → 重写 /sys/class/infiniband* 路径    │
│  libibmockumad.so  → 代理 libibumad 到 mock-ib daemon    │
│  libibmockverbs.so → 代理 /dev/infiniband/uverbsN        │
├──────────────────────────────────────────────────────────┤
│  mock-ib daemon (Unix socket)                            │
│  → SA 路径查询 / ibping / SMP 合成                        │
├──────────────────────────────────────────────────────────┤
│  fake sysfs 树 (/var/lib/nvml-mock/ib/sys/class/...)     │
└──────────────────────────────────────────────────────────┘
libibmocksys.so— 重写 sysfs 访问,使ibstat/ibstatus/iblinkinfo读取 mock 树libibmockumad.so— 代理libibumad的umad_send/umad_recv到mock-ibdaemonlibibmockverbs.so— 代理/dev/infiniband/uverbsN,使libibverbs枚举 HCA
Profile 默认 IB 配置
| Profile | IB | HCA | 速率 |
|---|---|---|---|
| a100 | ✅ | ConnectX-6 (MT4123) | HDR 200 Gb/s |
| h100 | ✅ | ConnectX-7 (MT4129) | NDR 400 Gb/s |
| b200/gb200/gb300 | ✅ | ConnectX-7 (MT4129) | NDR 400 Gb/s |
| l40s/t4 | ❌ | — | — |
跨节点 ibping
mock-ib 在每个 pod 中启动,暴露 headless Service(端口 18515)用于 TCP fabric relay。Chart 自带 NetworkPolicy 限制入站流量仅来自 nvml-mock pods。
验证脚本:tests/e2e/validate-ibping.sh
IB 配置 schema
| 字段 | 默认值 | 说明 |
|---|---|---|
enabled |
false |
启用 IB 模拟 |
hca_type |
MT4129 |
HCA 型号 |
fw_version |
28.39.2048 |
固件版本 |
link_layer |
InfiniBand |
InfiniBand 或 Ethernet |
rate_gbps |
400 |
100/200/400/800 |
port_state |
ACTIVE |
DOWN/INIT/ARMED/ACTIVE |
hcas_per_gpu |
1 |
每 GPU 的 HCA 数 |
guid_prefix |
a088c20300ab |
Node/Port GUID 前缀 |
PCIe 拓扑模拟
每个 profile 包含 pcie_topology: 块,描述主机的 PCI root complex 布局。render-pci-sysfs 启动时读取并写入 fake sysfs 树。
Profile 默认拓扑
| Profile | Root Complexes | NUMA Nodes | 每 Root 设备数 |
|---|---|---|---|
| a100/h100/b200/l40s | 2 (pci0000:00, pci0000:80) | 2 (双路) | 4 |
| gb200 | 4 (pci0000:00, :40, :80, :c0) | 4 (per Grace pair) | 2 |
| t4 | 1 (pci0000:00) | 1 | 4 |
验证规则
render-pci-sysfs 启动时验证:
- 每个 BDF 必须也出现在
devices[]中 - 每个 BDF 最多属于一个 root complex
- Root complex ID 必须匹配
pciDDDD:BB - BDF 必须使用 4 位域格式(
DDDD:BB:DD.F)
NRI 插件(可选)
当 nri.enabled=true 时,Chart 额外部署 nvml-mock-nri — 一个 node-local containerd NRI 插件,在容器创建时注入 mock 环境,使普通 pod 能运行 nvidia-smi 而无需 pod-spec 修改。
工作原理
Container 创建请求
    │
    ▼
┌─────────────────────────────────┐
│  nvml-mock-nri (NRI Plugin)     │
│  1. 挂载 host overlay 到容器     │
│  2. 注入 mock 环境变量/设备      │
│  3. 写入 OCI spec 调整          │
└─────────────────────────────────┘
    │
    ▼
容器启动 → nvidia-smi 可用
设备注入模式
| 模式 | 机制 | 依赖 |
|---|---|---|
raw(默认) |
直接在 NRI adjustment 中注入 /dev/nvidia* |
无 |
cdi |
发出 CDI device reference nvml-mock.nvidia.com/gpu=all |
运行时需启用 CDI |
⚠️ 重要:安装时必须指定独立 namespace(-n nvml-mock --create-namespace),否则 NRI 插件会排除 default namespace,所有 pod 都不会被注入。
故障模式
| Fail-closed | Fail-open | |
|---|---|---|
| 运行时行为 | 拒绝创建容器 | 容器正常启动但无 mock GPU |
| 表现 | Pod 卡在 ContainerCreating |
Pod 看似正常但缺少 GPU |
| 风险 | 测试中断(自宣布) | 测试结果失真(静默失败) |
Chart 的姿态是 "可检测的 fail-open":
| 探针 | 端点 | 用途 |
|---|---|---|
| Readiness | /readyz |
检测插件是否注册且响应中(503 = 未注入) |
| Liveness | /healthz |
检测 handler 是否卡死(2× containerd plugin_request_timeout 后重启) |
动态指标
默认 mock 完全静态。设置 gpu.dynamicMetrics.enabled=true 使 mock 返回波动值:
温度
| 参数 | 说明 |
|---|---|
base_c |
基准温度 |
variance_c |
波动幅度 |
ramp_c / ramp_period_sec |
渐变参数 |
功耗
| 参数 | 说明 |
|---|---|
base_mw |
基准功耗(毫瓦) |
variance_mw |
波动幅度(受 profile min/max 限制) |
利用率
| pattern | 行为 |
|---|---|
idle |
[gpu_min, gpu_max] 下方 1/4 |
busy |
[gpu_min, gpu_max] 上方 1/4 |
burst |
交替 idle/busy(每 burst_period_sec) |
steady |
完整 [gpu_min, gpu_max] 范围 |
解析优先级:chart baseline < profile default < user override
故障注入
设置 gpu.failureInjection.enabled=true 模拟 GPU 故障:
| 模式 | 受保护 API 调用 | Handle 查找 | ECC 计数器 | Event Set |
|---|---|---|---|---|
healthy |
正常 | 正常 | 零 | 空 |
lost |
ERROR_GPU_IS_LOST |
ERROR_GPU_IS_LOST |
错误 | 空 |
fallen_off_bus |
ERROR_GPU_IS_LOST |
ERROR_GPU_IS_LOST |
错误 | 空 |
ecc_uncorrectable |
正常 | 正常 | 严格递增 | XID 事件(若配置) |
触发方式:
- 确定性:
after_calls: N(第 N 次 NVML 调用后激活) - 随机性:
probability: 0.0~1.0(每次调用概率触发)
故障注入可与动态指标组合:设备在健康时返回动态读数,触发后切换到故障模式。一旦触发,设备在 pod 生命周期内保持故障状态。
Helm Values 配置
核心 GPU 设置
| 参数 | 默认值 | 说明 |
|---|---|---|
gpu.profile |
a100 |
GPU profile |
gpu.count |
8 |
每节点 mock GPU 数 |
gpu.customConfig |
"" |
自定义配置(替换整个 profile) |
gpu.dynamicMetrics.enabled |
false |
动态指标 |
gpu.failureInjection.enabled |
false |
故障注入 |
gpu.failureInjection.mode |
healthy |
故障模式 |
gpu.failureInjection.probability |
0.0 |
随机触发概率 |
gpu.failureInjection.after_calls |
0 |
确定性触发调用数 |
镜像 & 调度
| 参数 | 默认值 | 说明 |
|---|---|---|
image.repository |
ghcr.io/nvidia/nvml-mock |
镜像仓库 |
image.tag |
latest |
镜像标签 |
driverVersion |
"" (auto) |
驱动版本(空则从 profile 读取) |
nodeSelector |
{} |
节点选择器 |
tolerations |
[{operator: Exists}] |
容忍度 |
InfiniBand
| 参数 | 默认值 | 说明 |
|---|---|---|
infiniband.mockTier |
"" (auto) |
off/sysfs/full |
infiniband.ping.port |
18515 |
Fabric relay 端口 |
infiniband.ping.networkPolicy.enabled |
true |
限制入站流量 |
NRI 插件
| 参数 | 默认值 | 说明 |
|---|---|---|
nri.enabled |
false |
部署 NRI 插件 |
nri.deviceInjectionMode |
raw |
raw 或 cdi |
nri.excludedNamespaces |
[] |
额外排除的 namespace |
nri.healthPort |
8080 |
健康检查端口 |
fake-gpu-operator 集成
| 参数 | 默认值 | 说明 |
|---|---|---|
integrations.fakeGpuOperator.enabled |
false |
创建 profile ConfigMaps |
integrations.fakeGpuOperator.targetNamespace |
"" (release ns) |
FGO namespace |
快速开始
Device Plugin on KIND
# 1. 创建集群
kind create cluster --name nvml-mock-test

# 2. 加载镜像
docker pull ghcr.io/nvidia/nvml-mock:latest
kind load docker-image ghcr.io/nvidia/nvml-mock:latest --name nvml-mock-test

# 3. 安装 nvml-mock
helm install nvml-mock oci://ghcr.io/nvidia/k8s-test-infra/chart/nvml-mock \
  --wait --timeout 120s

# 4. 验证
kubectl rollout status daemonset/nvml-mock --timeout=60s

# 5. 部署 device plugin
kubectl apply -f tests/e2e/device-plugin-mock.yaml

# 6. 检查可分配 GPU
kubectl get nodes -o jsonpath='{.items[0].status.allocatable.nvidia\.com/gpu}'
# 期望: 8
DRA Driver on KIND
# 1. 创建启用 DRA 的集群
kind create cluster --name nvml-mock-dra \
  --config tests/e2e/kind-dra-config.yaml

# 2. 安装 nvml-mock(同上)

# 3. 安装 DRA driver
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia
helm install nvidia-dra-driver-gpu nvidia/nvidia-dra-driver-gpu \
  --set nvidiaDriverRoot=/var/lib/nvml-mock/driver \
  --set gpuResourcesEnabledOverride=true \
  --set resources.computeDomains.enabled=false

# 4. 验证 ResourceSlices
kubectl get resourceslices -o jsonpath='{.items[0].spec.devices}' | jq length
# 期望: 8
多节点异构 GPU 集群
# 1. 创建带标签 worker 的 Kind 集群
kind create cluster --name gpu-fleet \
  --config tests/e2e/kind-multi-node-config.yaml

# 2. 安装不同 profile
# A100 节点
helm install nvml-mock-a100 oci://ghcr.io/nvidia/k8s-test-infra/chart/nvml-mock \
  --set gpu.profile=a100 --set gpu.count=4 \
  --set nodeSelector.nvml-mock/profile=a100

# T4 节点
helm install nvml-mock-t4 oci://ghcr.io/nvidia/k8s-test-infra/chart/nvml-mock \
  --set gpu.profile=t4 --set gpu.count=2 \
  --set nodeSelector.nvml-mock/profile=t4
与 fake-gpu-operator 的关系
| 维度 | nvml-mock | fake-gpu-operator (Run:ai) |
|---|---|---|
| 模拟层级 | 驱动级(真实 NVML API) | K8s API 级(虚拟节点) |
| 保真度 | nvidia-smi 可运行 |
仅 K8s 资源对象 |
| 适用场景 | 真实节点上的组件测试 | 大规模集群调度模拟 |
| 互补性 | 提供底层 NVML fidelity | 处理 KWOW 虚拟节点 |
启用集成后,nvml-mock 为每个 profile 创建 gpu-profile-<name> ConfigMap,FGO 的 loader 读取。需设置 FGO 的 builtinProfiles.enabled=false。
节点标签
| 标签 | 写入者 | 条件 |
|---|---|---|
nvidia.com/gpu.present=true |
nvml-mock (kubectl label) | 始终写入 |
feature.node.kubernetes.io/pci-10de.present=true |
NFD (feature file) | nodeLabels.pciVendorPresent=true |
NFD 的 PCI source 无法看到 mock GPU,因为
nfd-worker是静态链接的,LD_PRELOAD对其无效。Feature file 是 workaround。
已知限制
| 限制 | 影响组件 | 影响 |
|---|---|---|
| Go 程序无法通过 LD_PRELOAD 拦截 PCIe sysfs | DRA driver | dra.k8s.io/pcieRoot 缺失,拓扑感知调度不可用(#265) |
| NUMA topology 不可用 | Device plugin | NUMA 感知拓扑提示不可用 |
| NFD PCI 检测不可用 | NFD | PCI feature labels 不自动检测(需 feature file workaround) |
ibv_devinfo 完整输出不支持 |
IB 工具 | libmlx5 的 verbs_open_device 发出真实 ioctl 无法 mock |
NRI 注入 pod 中 ibv_devinfo -l 报告 0 HCA |
IB 工具 | 枚举需要 libibverbs 匹配 provider driver,用 ibstat -l 替代 |
| IB 工具是 glibc 二进制 | Alpine 镜像 | musl 不兼容,PT_INTERP 指向 /lib/ld-linux-*.so.* |
前置条件
| 工具 | 版本 | 用途 |
|---|---|---|
| Docker | 20.10+ | 构建镜像 |
| Kind | 0.20+ | 本地集群 |
| kubectl | 1.31+ | 集群访问 |
| Helm | 3.x | Chart 安装 |
| Go | 1.25+ | 源码构建 |
| jq | any | DRA 验证 |
集群要求:允许特权 pod;DRA 需要 K8s 1.32+ 且启用 DynamicResourceAllocation feature gate。
相关链接
调研日期:2026-08-02