SemiAnalysis 发布 AgentX InferenceXv3 研报,Mooncake 成为关键基础设施
SemiAnalysis 发布 AgentX InferenceXv3,用大规模真实 Agentic workload 重新审视推理系统性能。随着长上下文、多轮交互和 KV Cache 复用成为常态,Agentic Inference 正从“拼算力”走向系统级优化,而 Mooncake 也正在其中扮演越来越重要的基础设施角色。
📝 摘要
SemiAnalysis 发布 AgentX InferenceXv3 研报,推出面向真实 Agentic Coding 场景的 AgentX 1.0 基准(trace 取自匿名化的 Claude Code 会话,总投入约 300 万美元),在超过 1000 颗 GPU 上评测多个主流推理框架。报告核心论点是:Agentic Inference 已经不是单纯的 chip/kernel 问题,而是一个 system-wide problem。当分布式推理集群同时服务数十万条 Agent 请求时,性能由 Router、Scheduler、KV Cache 管理、数据传输、Context Parallelism 等整条链路共同决定。Mooncake 位于推理栈的 KV Cache 管理与传输层,在长上下文、多轮 Agent 场景中负责 KV 在 GPU/CPU DRAM/远端节点之间的保存、复用和传输,正在成为 Agentic Inference 的关键基础设施。
核心概念: Agentic Inference 的性能瓶颈已从 GPU 算力转向系统级协同效率,KV Cache 的跨轮次管理与传输成为决定性因素。
关键技术栈 / 关键要点:
- AgentX 1.0 Benchmark — 首个面向真实 Agentic workload 的评测基准,覆盖多轮交互、长上下文、高 Prefix 复用、Sub-agent Burst 和 Tool Call
- 推理栈五层分解 — Router → Inference Engine/Scheduler → KV Cache Manager → Data Transfer Layer → Context Parallelism,各层独立又彼此耦合
- Mooncake Store + Transfer Engine — vLLM 通过 MooncakeStoreConnector 将 Host DRAM 纳入外部 KV Cache Pool,Store 负责 Placement/Eviction/Lifecycle,Transfer Engine 负责跨存储层级数据搬运
- Hybrid Attention 支持 — 不同 Cache Group 的 Shape 和生命周期差异,vLLM 为 Mooncake 增加了 Hybrid Memory Allocation Support
- Speculative Decoding 状态一致性 — Mooncake 补齐了 merged cache groups 间 EAGLE 等 speculative state 的正确保留和传播
- Store Path 优化 — 避免重复 In-flight Store、只写新增 KV Range、Lookup 异步化,显著降低高并发 Agent workload 下外部 Cache 路径的额外成本
- AMD ROCm 支持 — 新增 HIP dma-buf 注册,使 AMD GPU Memory 可直接注册到 RDMA transport,减少数据 staging 中转
关键结论 / 实践建议: Agentic Inference 优化边界正在从 GEMM/Attention Kernel 扩张到 Router、Scheduler、KV Cache、Transfer Engine、Context Parallelism 的组合效率;Mooncake 作为可插拔 KV Cache 管理层,正在形成与推理引擎解耦的独立生态。
近日,知名半导体与 AI 基础设施研究机构 SemiAnalysis 发布了最新报告 《AgentX - InferenceXv3: Does CUDA Moat Hold up in Agentic Inferencing?》 ,并正式推出面向真实 Agentic Coding 场景的 AgentX 1.0 基准。其 trace 取自匿名化的 Claude Code 会话,总投入约 300 万美元。
不同于传统的 benchmark, AgentX 将多轮交互、超长上下文、高 Prefix 复用、Sub-agent Burst、KV Cache Offload 与 Tool Call 等真实 Agent 工作负载纳入测试,并在超过 1000 颗 GPU、多个主流推理框架与软硬件栈上展开大规模评测。
这次的报告将关注点从单纯的 GPU 与 Kernel 性能扩展到 Router、Scheduler、KV Cache、数据传输和 Prefill/Decode 解耦等系统问题。 Mooncake 位于这套推理栈的 KV Cache 管理与传输层,围绕真实 Agent workload 持续进行相应优化。
AgentX 1.0:面向真实 Agentic Workload 的 Benchmark
SemiAnalysis 在这份 InferenceXv3 报告中推出了全新的 AgentX 1.0 Benchmark ,核心目标是让推理评测更接近真实的 Agentic workload。
传统 inference benchmark 往往采用固定输入长度、固定输出长度的单轮请求,例如 8K input / 1K output,并以吞吐、TTFT 或单 Token 延迟等指标衡量系统性能。这类测试非常适合评估 GPU 算力、Kernel 和推理引擎本身的效率,但随着 Agent 应用快速发展,它已经越来越难代表真实生产环境中的推理模式。
AgentX 1.0 则把评测对象从“单次生成”扩展到了完整的 Agent 交互过程。它基于真实 Agentic Coding workload,覆盖了多轮交互、持续增长的长上下文、高比例 Prefix reuse、Tool Call,以及 Sub-agent 带来的突发式并发等典型特征。与此同时,随着上下文不断积累,KV Cache 的保存、复用和 Offload 也被纳入整个系统性能的考量。
这意味着, AgentX 关注的不再只是“GPU 每秒能生成多少 Token”,而是一个 Agent 从接收任务、持续推理、调用工具到完成整个任务的真实体验。 SemiAnalysis 也因此在超过 1000 颗 GPU、不同推理框架以及 NVIDIA 、 AMD 等软硬件栈上进行了大规模测试,希望回答一个更贴近当下的问题:
当 LLM 从 Chatbot 走向 Agent,我们究竟应该如何衡量推理系统的性能?
Agentic Inference 正在变成一个完整的系统问题
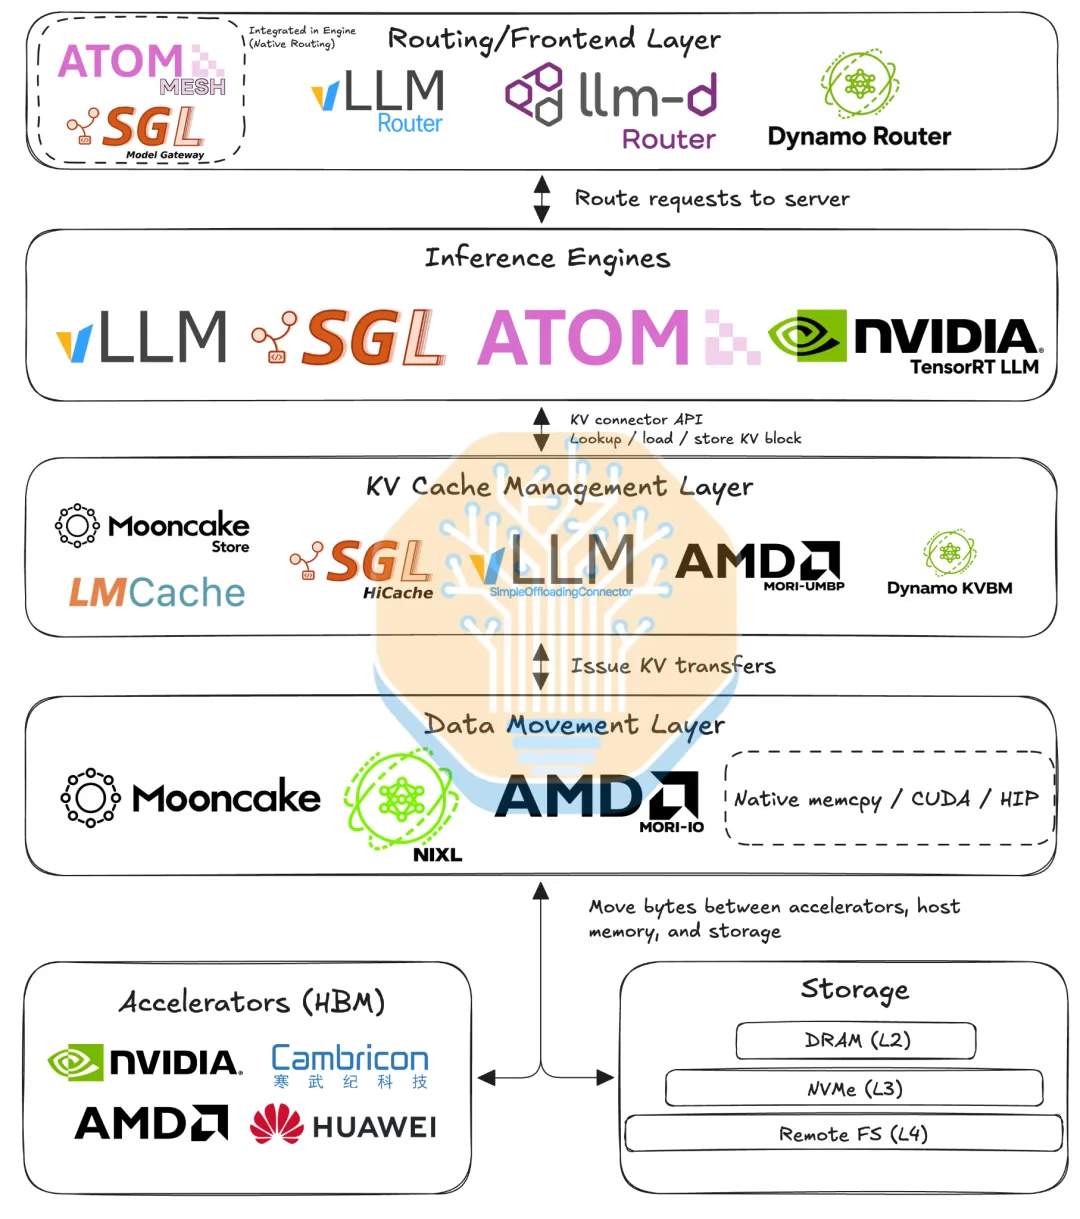
对于 Agentic Inference 生态, SemiAnalysis 认为: Agentic Inference 已经不是单纯的 chip/kernel 问题,而是一个 system-wide problem。 当一个分布式推理集群同时服务数十万条 Agent 请求时,性能开始由一整条链路共同决定:请求如何路由、Scheduler 如何分配资源、KV Cache 如何保存和复用、不同显存和内存层级之间如何搬运数据,以及这些机制如何与长上下文、混合注意力和分离式 Prefill/Decode 协同工作。
图片来源:https://newsletter.semianalysis.com/p/agentx-inferencexv3-does-cuda-moat
从系统结构上看,这套生态可以大致拆成几个相互独立、又彼此耦合的层次。
最上层是 Router 。在 Data Parallel、Disaggregated Serving 等部署中,不同 Worker 往往拥有各自独立的 KV Cache,因此请求不能只按照“哪台机器更空闲”来调度。对于已经存在大量历史上下文的 Agent session,更合理的策略是尽量把后续请求送回持有对应 Prefix Cache 的 Worker,否则一次错误的路由就可能把 Cache Hit 变成重新 Prefill。报告提到,当前生态中既有独立的 vLLM Router 、 llm-d Router ,也有集成在推理引擎内部的 SGLang Model Gateway 和 ATOM Mesh 。
再往下是 Inference Engine 与 Scheduler 。 vLLM 、 SGLang 、 TensorRT-LLM 、 ATOM 等引擎负责真正执行 Prefill 和 Decode,但在 Agentic workload 下,Scheduler 面对的不再是大小近似的独立请求,而是一组长度持续变化、彼此共享 Prefix、并且可能随时产生 Sub-agent 分支的长生命周期 session。这会让 Cache eviction、Prefill/Decode 调度甚至一些看似很小的 CPU bookkeeping 都进入性能关键路径。 AgentX 也正是在这些真实流量下推动了大量针对 vLLM 、 SGLang 、 TensorRT-LLM 和 ATOM 的上游优化。
第三层是 KV Cache Manager 。随着上下文从数万 token 增长到数十万甚至百万 token,仅依赖 GPU HBM 保存全部 KV 已经越来越困难,因此推理引擎开始通过 Connector 接入外部 KV Cache 管理系统,将可复用状态扩展到 CPU DRAM、NVMe 或远端节点。报告特别强调,这一层正在形成一个可插拔生态:推理引擎暴露统一接口,而不同的 KV Cache Manager 可以独立负责 Cache placement、eviction、lookup 和 reuse。
与 Cache Manager 配套的则是 Data Transfer Layer 。KV 被放到哪里是一回事,如何高效地在 GPU、Host Memory 和不同节点之间移动又是另一回事。在 Disaggregated Prefill/Decode 架构下,一个请求的 KV 可能需要从 Prefill GPU 发送到 Decode GPU,同时还要被保存到外部 Cache 中供下一轮复用。因此同一个推理系统里完全可能同时存在多条数据路径,不同 Transfer Engine 分别负责不同的 KV movement。
长上下文还进一步催生了 Context Parallelism 。传统 Tensor Parallel 或 Data Parallel Attention 在上下文持续变长后会暴露新的效率和显存问题,因此报告专门讨论了 Prefill Context Parallelism(PCP)和 Decode Context Parallelism(DCP):前者把长 Prompt 的 Prefill 计算拆到多张 GPU,后者把 KV scan 分散到不同 Rank,从而提高长上下文下的 TTFT 和 Decode 效率。
因此,从 AgentX 的结果来看,Agentic Inference 的优化边界正在明显扩张。过去我们可能主要关注 GEMM、Attention Kernel 或 GPU 利用率,而现在真正影响端到端性能的,往往是 Router、Scheduler、KV Cache、Transfer Engine、Context Parallelism 以及底层硬件和软件栈之间的组合效率 。
Mooncake 在 Agentic Inference 中的位置
把前面的推理栈拆开之后, Mooncake 所处的位置其实很清楚:它主要解决的是 KV Cache 在不同存储层级和不同节点之间的管理与传输问题 。
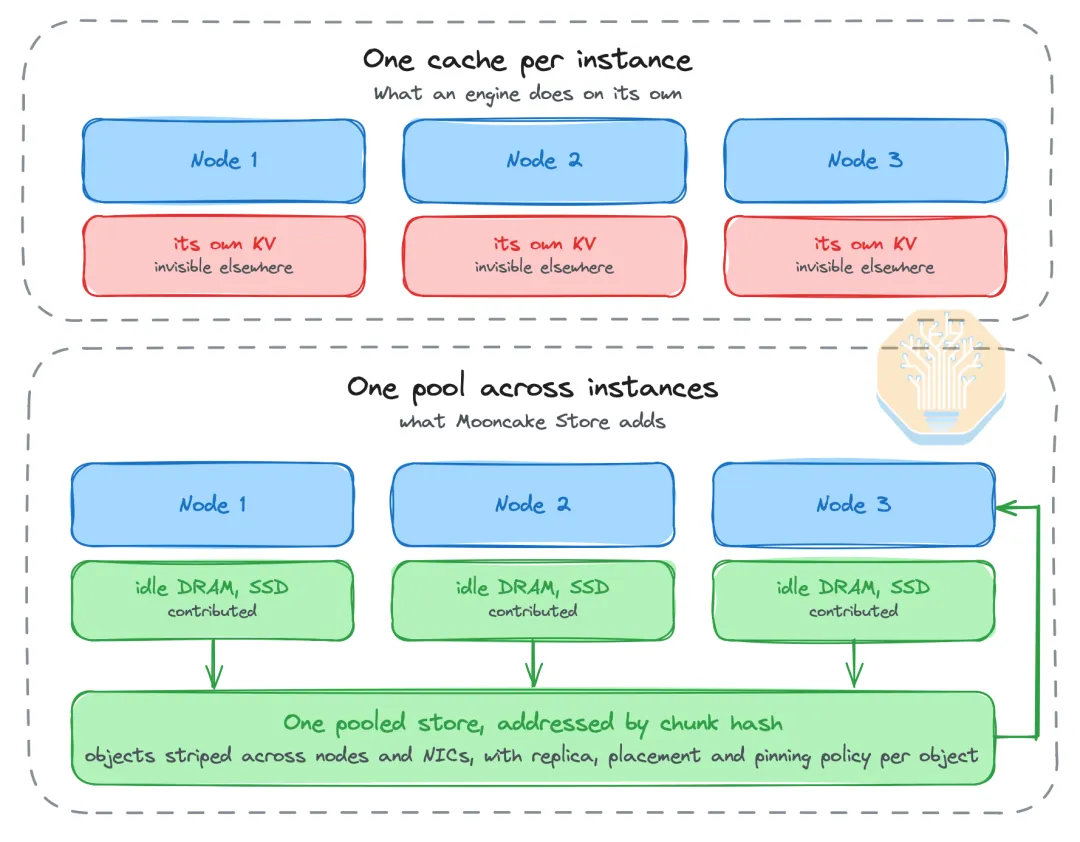
在长上下文、多轮 Agent 场景中,KV Cache 会逐渐从一次请求里的临时状态,演变成需要跨轮次持续复用的长期状态。每一轮都重新 Prefill 会带来大量重复计算,而完全依赖 GPU HBM 保存所有 KV,又很容易在高并发和长上下文下触及显存容量上限。因此,实际系统往往需要把 KV 扩展到 Host DRAM,甚至远端节点,并在需要时重新加载到 GPU。
在 AgentX 当前采用的一种部署方式中, Mooncake Store 与 vLLM 部署在同一节点。每个 vLLM Worker 内嵌一个 Mooncake Store Client,并将部分 Host DRAM 纳入外部 KV Cache Pool。vLLM 通过 MooncakeStoreConnector 将可复用的 KV Block 从 Host Memory 加载回 GPU,或者把新计算得到的 KV 写入外部 Cache。Mooncake Store 负责 Cache 的 Placement、Eviction 和生命周期管理,而真正的数据搬运则由 Mooncake Transfer Engine 完成,包括 GPU、CPU DRAM 以及远端节点之间的传输。
图片来源:https://newsletter.semianalysis.com/p/agentx-inferencexv3-does-cuda-moat
AgentX 的真实 Agent workload 也暴露了这一层在工程实现上的很多细节问题。以 Hybrid Attention 模型为例,不同 Cache Group 往往具有不同的 Shape 和生命周期,传统假设“所有 Token 使用统一 KV Layout”的 Connector 很难正确表达这些状态。vLLM 后续为 Mooncake 增加了对应的 Hybrid Memory Allocation Support ,使不同类型的 KV 和 Recurrent State 能够被更准确地管理和复用。
对于 Speculative Decoding 场景, Mooncake 还进一步补齐了状态一致性问题,包括在 merged cache groups 之间正确保留和传播 speculative decoding state,避免多轮 Agent session 在 KV Cache 复用过程中丢失 EAGLE 等 speculative state。
另一个明显的优化方向是 Store Path 本身。在真实的多轮 Agent 流量中,大量 Session 会共享相同 Prefix,如果每个请求都重复写入相同 KV,或者每一轮都完整重写整个 Prefix,传输和 CPU 开销会迅速放大。围绕这一问题,vLLM 侧陆续加入了多项优化,包括避免重复的 In-flight Store、只写入新增 KV Range、将 Lookup 异步化,以及减少 Key 构造和传输路径上的额外开销。这些改动并不改变 Mooncake 的基本架构,但显著降低了高并发 Agent workload 下外部 Cache 路径的额外成本。
报告还专门讨论了 Mooncake 在 AMD ROCm 上的完善。此前, NVIDIA 平台可以通过 nvidia-peermem 或 dma-buf 进行 GPU-direct RDMA 注册,而 AMD 缺少对应的 nvidia-peermem 路径。在没有 HIP dma-buf registration 的情况下,KV 跨节点传输需要经过 Host DRAM 中转。Mooncake 新增的 HIP dma-buf 支持补齐了这一能力,使 AMD GPU Memory 可以直接注册到 RDMA transport,从而减少额外的数据 staging。
写在最后
很高兴 Mooncake 社区能参与到此次的评测中,把 Mooncake 放进更真实、更复杂的推理配置里去测,在公开、可复现的 benchmark 中暴露问题、验证优化,才能让 KV Cache 这层基础设施的 trade-off 更清楚,正如我们在 InferenceX™ Initiative Supporters 页面所写:
相关链接
关于 KVCache.AI
KVCache.AI 是一个专注于大模型基础设施与推理优化的开放组织。我们通过开源项目、系统实践和学术研究,持续提升大模型部署与服务效率,降低部署成本与复杂度,让更多团队能够用得起、用得好大模型基础设施。我们的开源项目包括 Mooncake、KTransformers 和 AgentENV。
Mooncake · Table of Contents